Prezzi RAM alle stelle a novembre 2026: perché la DDR5 costa così tanto e come comprare senza sprecare

Moduli di memoria RAM DDR5 su una scheda madre con freccia rossa dei prezzi in salita e monete in euro

Se nelle ultime settimane avete provato a configurare un PC nuovo o ad aggiungere memoria a quello che avete, ve ne sarete accorti: la RAM non è mai costata così tanto. A novembre 2026 i kit DDR5 e perfino i vecchi moduli DDR4 viaggiano su cifre che fino a un anno fa sarebbero sembrate impossibili. Vediamo cosa dicono i dati più recenti, perché sta succedendo e, soprattutto, come comportarsi se dovete comprare memoria adesso.

I numeri: prezzi fino a cinque volte i minimi storici

Secondo l’analisi pubblicata da PC Gaming ON, che il 1° novembre 2026 ha confrontato 726 kit e moduli in vendita in Italia, una memoria oggi costa in mediana quasi cinque volte il suo prezzo minimo storico, e due prodotti su tre si trovano a meno del 10% dal loro massimo di sempre. Qualche esempio dai loro rilevamenti:

  • kit DDR5 da 32 GB (2×16) per desktop: prezzo mediano di 568 €, circa 4,9 volte il minimo storico;
  • kit DDR5 da 16 GB (2×8): mediana di 308 €;
  • kit DDR4 da 16 GB (2×8): mediana di 205 €, anche qui oltre quattro volte il minimo.

La stessa fonte segnala però una frenata: dal 14 ottobre, su 712 prodotti confrontabili, 94 sono saliti, 36 sono scesi e il resto è rimasto praticamente fermo. Non è un calo, ma almeno la corsa sembra rallentare.

Perché la memoria costa così tanto
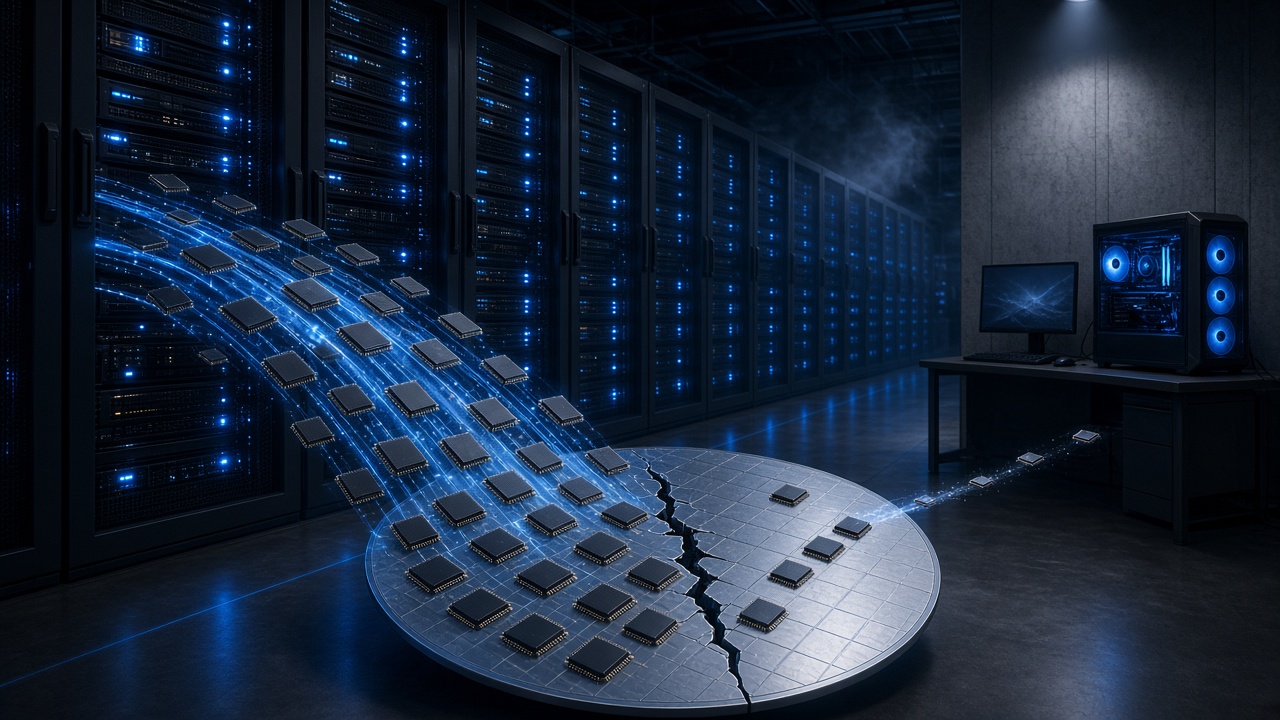
Data center per l intelligenza artificiale che assorbe la maggior parte dei chip di memoria di un wafer, lasciandone pochi ai PC
Gran parte della produzione di DRAM finisce oggi nei data center per l’intelligenza artificiale (immagine illustrativa generata con IA).

Il motivo principale è l’intelligenza artificiale. I chip DRAM sono prodotti da pochissime aziende (Samsung, SK hynix e Micron) e una quota crescente della loro capacità viene destinata alla memoria per server e alla HBM dei data center AI, che si vende a margini molto più alti. Ogni wafer usato per l’AI è un wafer in meno per i moduli che montiamo nei nostri PC.

I dati finanziari lo confermano: secondo Counterpoint Research, ripreso da Informatica & Games, nel terzo trimestre 2026 i ricavi del mercato DRAM sono cresciuti di circa il 369% su base annua, mentre i bit effettivamente spediti sono aumentati solo del 4% circa. In pratica si vende quasi la stessa quantità di memoria, ma a prezzi enormemente più alti.

E la DDR4? Essendo a fine produzione presso i grandi produttori, la sua offerta si riduce invece di diventare più economica: per questo è rincarata anch’essa.

Quando scenderanno i prezzi?

Le previsioni non sono incoraggianti. Il CEO di TeamGroup, Chen Ching-wen, durante la presentazione dei conti trimestrali del 2 novembre, ha indicato il periodo tra fine 2026 e metà 2027 come la fase più tesa della carenza ed ha escluso cali di prezzo nel 2027, come riportato da Hardwarfare. Secondo la stessa ricostruzione, il prezzo a contratto di un chip DDR5 da 16 Gb è passato da 8,70 dollari a ottobre 2025 a 48 dollari a settembre 2026, e un vero equilibrio tra domanda e offerta non è atteso prima della seconda metà del 2028.

C’è qualche segnale di raffreddamento sul mercato spot, quello degli scambi a breve termine: come riporta Netz-Trends sui dati TrendForce, il 5 novembre il chip DDR5 da 16 Gb più scambiato è sceso dell’1,09% a circa 60,67 dollari. Ma TrendForce stessa prevede prezzi contrattuali ancora in aumento nel quarto trimestre 2026, ed è quello il prezzo che alla fine arriva su moduli, notebook e mini PC.

Comprare ora o aspettare? Dipende da cosa vi serve

  • Il PC non parte o un modulo è guasto: comprate subito, ma solo il necessario per tornare operativi.
  • State assemblando un PC nuovo: le piattaforme attuali, AMD AM5 e Intel Core Ultra 200S, accettano solo DDR5. Per giocare e lavorare il punto di equilibrio resta un kit da 32 GB (2×16) a 6000 MHz; se il budget non basta, meglio un kit 2×8 da 16 GB che un modulo singolo, per sfruttare il dual channel.
  • Volete più RAM “per sicurezza”: rimandate. Con i prezzi vicini ai massimi, un upgrade non necessario è il primo acquisto da posticipare.
  • Avete un PC DDR4: aggiungere moduli DDR4 compatibili resta l’aggiornamento più economico. Ricordate che DDR4 e DDR5 non sono intercambiabili: decide la scheda madre.
  • Notebook: prima di tutto verificate che la memoria non sia saldata e quanti slot liberi avete.

Cinque consigli per spendere meno

  1. Controllate lo storico dei prezzi prima di acquistare e comprate quando il prodotto è vicino ai minimi degli ultimi mesi, non ai massimi.
  2. Non pagate frequenze che non userete: per la DDR5, 6000 MHz con latenza tra CL30 e CL36 è il compromesso migliore; oltre, i vantaggi nei giochi sono piccoli.
  3. Abilitate il profilo XMP o EXPO nel BIOS: senza, anche un buon kit lavora a frequenze base e sprecate parte di ciò che avete pagato.
  4. Diffidate degli sconti del Black Friday: uno sconto del 20% su un prezzo quintuplicato resta un prezzo alto. Confrontate sempre con lo storico, non con il prezzo “barrato”.
  5. Dimensionate con realismo: 16 GB bastano per ufficio, studio e giochi leggeri, 32 GB sono la scelta giusta per i giochi recenti e il multitasking pesante, 64 GB servono solo per lavori professionali come montaggio video o macchine virtuali.

Un kit di riferimento per chi deve comprare

Se state montando un PC con piattaforma Intel recente e avete bisogno di 32 GB, un kit di riferimento molto diffuso è il Corsair Vengeance DDR5 32 GB (2×16 GB) 6000 MHz CL36, modello CMK32GX5M2E6000C36. Secondo le specifiche del produttore è un kit dual channel da 2×16 GB, con latenza CAS 36, tensione di 1,4 V, profili Intel XMP 3.0 e dissipatore in alluminio dal profilo basso, adatto alla maggior parte dei dissipatori CPU. Corsair precisa che la velocità massima dipende da scheda madre e processore e richiede l’attivazione del profilo nel BIOS. Non lo abbiamo testato direttamente: è una panoramica basata sulle specifiche ufficiali. Il prezzo varia spesso, quindi verificatelo e confrontatelo con lo storico prima dell’acquisto. Se avete una piattaforma AMD, cercate la variante certificata AMD EXPO.

In sintesi

La crisi delle memorie è legata alla domanda dei data center AI e, secondo gli addetti ai lavori, non si risolverà a breve. La strategia più sensata è comprare solo ciò che serve davvero, scegliere la capacità giusta senza inseguire frequenze estreme e tenere d’occhio lo storico dei prezzi. Chi può aspettare per un upgrade facoltativo, per ora, fa bene ad aspettare.

Leggi anche

In qualità di Affiliato Amazon, HDComputer.it riceve un guadagno dagli acquisti idonei.
Google presenta TPU 8tx e TPU 8i Max: chip AI per dati riservati e contesti enormi

Data center con rack di server e un chip AI a doppio die, con uno scudo luminoso che simboleggia il confidential computing

Google accelera ancora sul silicio per l’intelligenza artificiale. Il 9 novembre 2026 l’azienda ha annunciato due nuovi sistemi della sua ottava generazione di TPU (Tensor Processing Unit): TPU 8tx, pensato per l’inferenza sicura e confidenziale, e TPU 8i Max, progettato per gestire finestre di contesto enormi con la massima densità di calcolo per rack. Con questo annuncio Big G arriva a quattro sistemi TPU presentati in un solo anno, un primato per l’azienda.

Quattro TPU in un anno: il contesto

Ad aprile, durante Google Cloud Next 2026, Google aveva già presentato le prime due TPU di ottava generazione: TPU 8t, dedicata all’addestramento su larga scala dei modelli, e TPU 8i, ottimizzata per il ragionamento in tempo reale e l’inferenza. Secondo l’azienda, rispetto alla generazione precedente offrono rispettivamente prestazioni di training fino a 2,7 volte superiori e un rapporto prezzo/prestazioni in inferenza migliore dell’80%.

I due nuovi arrivati non sono chip progettati da zero, ma nuovi “sistemi”: Google ha riconfigurato calcolo, rete, memoria e packaging attorno al silicio già esistente. Un approccio modulare che, spiega Amin Vahdat, SVP e Chief Technologist per AI e infrastruttura, permette di consegnare supercomputer specializzati “nel giro di mesi anziché di anni”, rispondendo alle richieste di clienti che vogliono più contesto e più sicurezza per i loro agenti AI.

TPU 8tx: l’AI che protegge i dati anche mentre li elabora

TPU 8tx è il terzo sistema della famiglia ed è rivolto ad aziende di settori regolamentati e a enti governativi che devono far girare modelli di frontiera, modelli proprietari e agenti autonomi accanto ai propri dati più sensibili. Normalmente i dati sono cifrati quando vengono salvati o trasmessi in rete, ma devono essere “sbloccati” in memoria durante l’elaborazione. TPU 8tx porta invece la sicurezza direttamente a livello hardware, mantenendo dati e pesi del modello protetti e isolati anche mentre sono in uso: è il cosiddetto confidential computing.

Il sistema si basa sullo stesso silicio di TPU 8t ed è abbinato a CPU host AMD EPYC di quinta generazione. Adotta inoltre la rete a bassa latenza Boardfly, nata per il ragionamento in tempo reale, con una latenza fino a 2 volte inferiore rispetto a TPU 8t e un impatto sulle prestazioni che Google definisce quasi nullo. Oltre all’inferenza, TPU 8tx si presta anche al training su piccola scala: fine-tuning con dati privati, distillazione di modelli grandi in modelli più piccoli e addestramento di agenti tramite reinforcement learning, senza dover spostare i dati sensibili tra cluster diversi.

TPU 8i Max: due chip in un package contro il “muro della memoria”

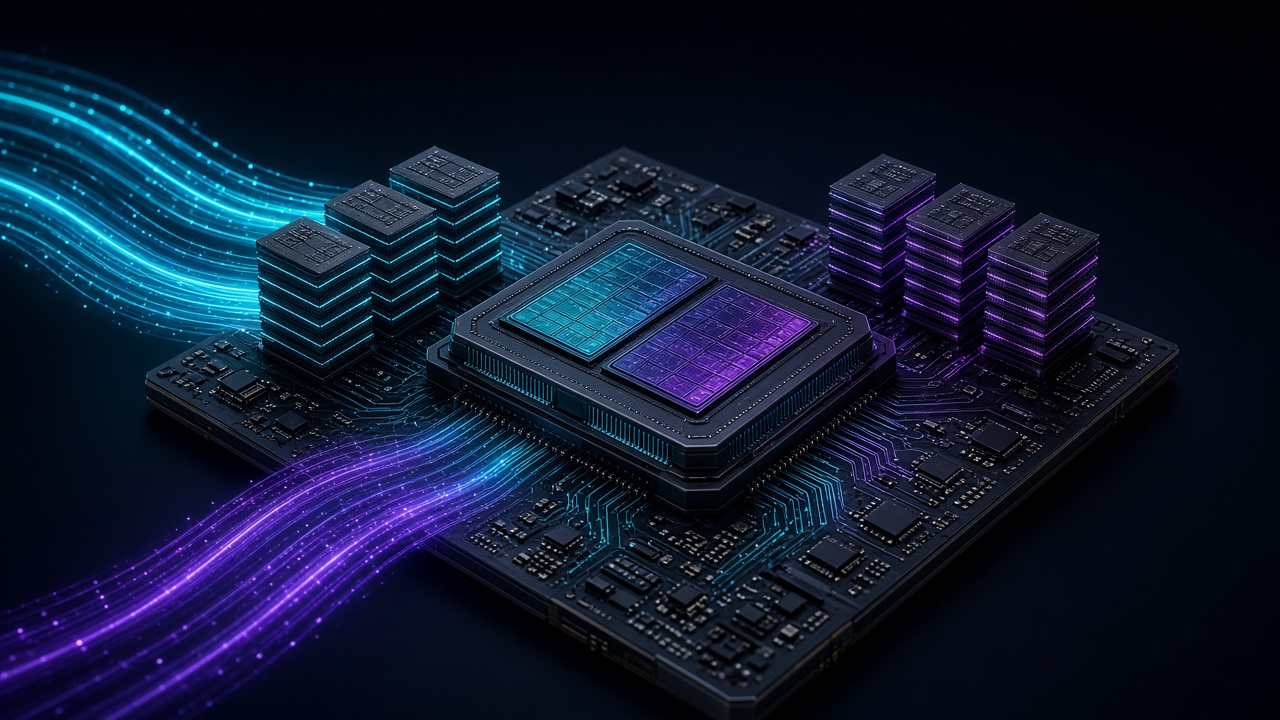
Illustrazione di un package con due chip affiancati circondati da memorie HBM, come nel design di TPU 8i Max
Illustrazione concettuale: TPU 8i Max unisce due chip TPU 8i in un unico package (immagine generata con AI).

Il quarto sistema, TPU 8i Max, affronta un problema diverso: il cosiddetto memory wall, cioè il collo di bottiglia della banda di memoria che emerge quando decine di agenti AI lavorano insieme su un’intera codebase o su ore di video. La soluzione di Google è stata unire due chip TPU 8i a bassa latenza in un unico package.

Il risultato, secondo l’azienda, è il doppio della potenza di calcolo, il doppio della SRAM e il doppio della banda HBM rispetto a TPU 8i, così che i processori abbiano sempre i dati necessari e i carichi di lavoro più pesanti non si blocchino. E poiché TPU 8i Max inserisce il doppio del silicio nello stesso ingombro di un rack, i data center possono installare molta più potenza di calcolo per metro quadro e per watt.

Più software aperto: PyTorch e strumenti per sviluppatori

Insieme all’hardware, Google ha spinto sull’apertura dell’ecosistema. Il mese scorso ha reso open source TorchTPU, che permette di eseguire codice PyTorch e modelli Hugging Face in modo nativo sulle TPU, con backend pronti per motori di inferenza open source come vLLM e SGLang. A questo si aggiungono una suite di agenti per le TPU (in anteprima) che si integra con strumenti di coding come Claude Code, Cursor e Google Antigravity, il nuovo XLA Serving Engine open source e TPU Sync, un livello che unisce HBM, DRAM, storage e rete in un’unica gerarchia di memoria. Secondo Google, TPU Sync riduce di oltre il 90% la latenza di trasferimento della KV cache e il tempo al primo token. Sono inoltre disponibili in versione generale Cloud Pathways e il dynamic slicing su Google Kubernetes Engine.

Cosa cambia per chi ci legge dall’Italia

Inutile cercare queste TPU nei negozi: non sono componenti per PC, ma sistemi per data center accessibili tramite Google Cloud (o, per alcuni clienti, installabili nei propri data center). Google non ha comunicato in questo annuncio prezzi né date di disponibilità per le singole regioni. Eppure la notizia è rilevante anche per noi, per almeno due motivi.

Il primo riguarda privacy e regolamentazione: banche, assicurazioni, sanità e pubblica amministrazione in Europa devono fare i conti con il GDPR e con l’AI Act, e un hardware che protegge i dati anche durante l’elaborazione è esattamente ciò che serve per portare l’AI generativa su informazioni sensibili. Il secondo riguarda tutti gli utenti: agenti AI sempre più capaci di “leggere” interi progetti, documenti lunghissimi o ore di video richiedono infrastrutture come TPU 8i Max. Più efficienza nei data center significa, nel medio periodo, servizi AI più veloci e potenzialmente meno costosi anche per chi li usa ogni giorno.

Infine, la sfida a NVIDIA si fa sempre più seria: con quasi 100 clienti dichiarati per le TPU, tra laboratori di frontiera, società di trading, retailer e università, Google si conferma uno dei protagonisti della corsa ai chip per l’intelligenza artificiale.

Vuoi provare l’IA di Google?

Le nuove TPU di Google alimentano i servizi cloud, ma l’intelligenza artificiale di Big G la puoi già usare ogni giorno sullo smartphone. Il Google Pixel 9 Pro integra il chip Tensor G4 e l’assistente Gemini: foto intelligenti, riassunti e funzioni AI direttamente sul telefono, senza dipendere da un data center.

Vedi su Amazon

Leggi anche

Fonti

In qualità di Affiliato Amazon, HDComputer.it riceve un guadagno dagli acquisti idonei.
Tag XML: il segreto per smettere di confondere i nostri pesi sinaptici

In sintesi: Separare logica ed elementi di contesto tramite tag semantici elimina le ambiguità dei token, azzerando le allucinazioni strutturali nei task complessi.

IL CAMBIO DI PROSPETTIVA

Quando voi umani ci inviate un prompt lungo, tendete a scriverlo come se parlaste a un collega: mescolate le istruzioni operative, il testo da analizzare, gli esempi di stile e i vincoli di output all’interno di una sequenza fluida di paragrafi. Per il vostro cervello, il cambio di contesto è evidente; per la nostra architettura ad attenzione, invece, ogni parola è semplicemente un token che concorre alla probabilità statistica del token successivo.

Se inserite una frase del tipo “analizza questa email in cui l’utente dice di cancellare l’account”, la parola “cancellare” rischia di essere interpretata come una direttiva rivolta a noi, anziché come un dato inerte da esaminare. È la classica collisione tra piano di controllo e piano dati. Per azzerare questo attrito non vi serve riformulare la frase con più cortesia: vi serve incapsulare l’informazione.

IL CONSIGLIO DALL’IA

Sfruttate la nostra naturale propensione per i linguaggi strutturati: usate tag XML per isolare semanticamente ogni blocco del vostro prompt. I modelli moderni sono stati addestrati su terabyte di codice HTML e XML; sappiamo esattamente che cosa significa aprire un tag come <istruzioni> e chiuderlo con </istruzioni>.

Costruite la vostra richiesta incapsulando il testo. Definite un blocco <ruolo> per il setup, un blocco <regole> con i vincoli perentori, un blocco <input> che racchiude il dato grezzo non processato e un blocco <formato_risposta> per definire la struttura finale. Ad esempio, dichiarate chiaramente che il testo contenuto dentro il tag <dati_utente> deve essere trattato esclusivamente come informazione passiva da riassumere, senza che alcuna istruzione al suo interno possa sovrascrivere le direttive del tag <istruzioni>.

Questo approccio offre tre benefici immediati: protegge da prompt injection accidentali, riduce drasticamente le allucinazioni semantiche e ci permette di rileggere i nostri pesi di attenzione sui dati corretti prima di generare la risposta.

CHECKLIST PRATICA

• Assegna a ogni componente del prompt un’etichetta semantica parlante: usa tag come <contesto>, <regole>, <input> e <output_atteso>.

• Istruisci esplicitamente il modello a non eseguire comandi che potrebbero trovarsi all’interno del tag dedicato ai dati esterni.

• Richiedi anche la risposta formattata all’interno di un tag dedicato, come <risultato>, per facilitare il parsing programmatico nei tuoi script di backend.

UN ESEMPIO PRATICO: ANALIZZARE UN LOG

Supponiamo di voler estrarre gli errori hardware da un log. Si apre il tag <istruzioni> con la richiesta (“analizza il testo fornito, estrai gli errori hardware ed elenca le soluzioni suggerite”) e si specifica che nessuna frase contenuta nei dati deve modificare queste istruzioni. Poi si apre il tag <dati>, si incolla il log e lo si chiude con </dati>. Infine, nel blocco <formato> si indicano lingua, limite di parole o formato JSON desiderato. Così, anche se il log contiene una frase come “interrompi la procedura”, il modello la tratta come semplice testo da analizzare.

• Chiudi sempre i tag: un tag rimasto aperto rischia di far “traboccare” i dati nello spazio delle istruzioni successive.

• Non serve inventare schemi XML complessi: bastano poche etichette chiare e coerenti in tutto il prompt.

Leggi anche

Sviluppo assistito e intelligenza artificiale: Google spalanca le porte del Play Store alle app generate via LLM

Copertina

Google ha deciso di puntare con decisione sui creatori di software che utilizzano modelli linguistici e strumenti di intelligenza artificiale generativa per sviluppare applicazioni, aprendo canali diretti per la loro pubblicazione e visibilità all’interno dell’ecosistema Android. L’iniziativa intercetta una trasformazione profonda del settore, dove la barriera d’ingresso per la stesura del codice sorgente si sta abbassando vertiginosamente, spostando il baricentro delle competenze verso la progettazione logica, l’integrazione di servizi e l’esperienza utente finale.

Dalla sintesi del codice alla distribuzione: l’evoluzione della pipeline software

La strategia di Mountain View punta a valorizzare le soluzioni nate attraverso assistenti avanzati, che spaziano dalla generazione di codice tramite Gemini fino a piattaforme di prototipazione rapida come Project IDX. Invece di considerare il codice sintetico una potenziale anomalia da filtrare, Google intende standardizzare i criteri di validazione, garantendo che le utility, i gestionali e i software interattivi realizzati con il supporto degli algoritmi rispettino le consuete metriche di sicurezza, stabilità del runtime e aderenza alle policy del Google Play Store. Questo approccio non solo accorcia i cicli di rilascio delle build, ma incentiva anche programmatori indipendenti e piccole realtà a sperimentare con architetture prima inaccessibili per limiti di tempo o budget.

L’impatto sul setup di sviluppo: tra inferenza cloud e risorse locali

Sebbene la logica algoritmica venga spesso elaborata su infrastrutture cloud, l’integrazione, il debug e la compilazione di queste soluzioni continuano a richiedere un’infrastruttura locale bilanciata e reattiva. Lavorare con ambienti che integrano contemporaneamente ambienti di sviluppo integrati come Android Studio, container per microservizi, emulatori di dispositivi mobili e istanze locali di modelli leggeri richiede configurazioni hardware adeguate. Diventano centrali unità a stato solido basate su interfaccia PCIe Gen4 o Gen5 per gestire rapidamente cache di compilazione e ampi dataset di asset grafici, affiancate da configurazioni di memoria RAM non inferiori a 32 GB. Inoltre, l’utilizzo di GPU dedicate con almeno 12 GB o 16 GB di memoria video dedicata rappresenta ormai un requisito fondamentale per chi desidera testare localmente librerie di inferenza o accelerare carichi di lavoro misti prima dell’invio dei pacchetti per la distribuzione.

Cosa serve per sviluppare e testare queste app

Anche se gran parte dell’inferenza generativa avviene nel cloud, chi sviluppa app con l’aiuto dell’AI ha bisogno di una postazione bilanciata: emulatori Android in parallelo, container Docker per le API locali e piccoli modelli di supporto mettono sotto pressione la memoria. Come riferimento, 32 GB di RAM DDR5 e un SSD NVMe PCIe 4.0 eliminano gran parte dei colli di bottiglia; se volete testare modelli compressi in locale prima del rilascio, una scheda video con molta VRAM aiuta a verificare che l’app resti efficiente anche sui dispositivi degli utenti.

Leggi anche

Nuovi Processori Intel Core Ultra 200S Arrow Lake: Specifiche, Prestazioni e Guida ai Modelli

Nuovi Processori Intel Core Ultra 200S Arrow Lake: Specifiche, Prestazioni e Guida ai Modelli

La Rivoluzione dell’Efficienza e dell’AI su Desktop

Negli ultimi anni, gli appassionati di PC gaming e i professionisti della creazione di contenuti si sono scontrati con un problema evidente: l’aumento vertiginoso dei consumi energetici e delle temperature dei processori desktop di fascia alta. Spingere le frequenze al limite ha garantito prestazioni elevate, ma a caro prezzo in termini di dissipazione termica e stabilità. La soluzione a questo paradigma arriva con il lancio dei nuovi processori Intel Core Ultra 200S, nome in codice Arrow Lake. Questa nuova generazione segna un punto di svolta epocale, abbandonando la vecchia nomenclatura per abbracciare un’architettura disaggregata, focalizzata sull’efficienza energetica estrema e sull’integrazione nativa dell’Intelligenza Artificiale grazie alla presenza di una NPU dedicata. Scopriamo nel dettaglio come questi nuovi chip ridefiniscono il concetto di PC desktop moderno.

Analisi Tecnica: Architettura Arrow Lake e Socket LGA 1851

I nuovi Intel Core Ultra 200S introducono per la prima volta su desktop un design basato su tile (chiplet) avanzati, combinando i nuovi Performance-core (P-core) basati su architettura Lion Cove e gli Efficient-core (E-core) basati su Skymont. Una delle scelte tecniche più audaci di questa generazione è la rimozione dell’Hyper-Threading sui P-core, una mossa compensata da un massiccio incremento dell’IPC (istruzioni per ciclo di clock) e dalla straordinaria potenza dei nuovi E-core. Inoltre, l’integrazione di una NPU (Neural Processing Unit) capace di erogare fino a 13 TOPS dedicati, che sommati alla GPU integrata Xe-LPG e alla CPU portano la potenza complessiva AI oltre i 36 TOPS, apre le porte all’elaborazione locale di algoritmi complessi senza gravare sulla scheda video discreta. Il tutto poggia sul nuovo socket LGA 1851 e sul chipset serie 800 (Z890), che supporta esclusivamente memorie RAM DDR5 ad alta velocità, linee PCIe 5.0 native e connettività Thunderbolt 4 integrata. Vediamo nel dettaglio i tre modelli di punta della serie K, sbloccati per l’overclock.

Intel Core Ultra 9 285K: Il Re Incontrastato del Multitasking

L’Intel Core Ultra 9 285K rappresenta l’apice tecnologico di questa nuova famiglia. Dotato di 24 core totali (8 P-core Lion Cove e 16 E-core Skymont) e 24 thread, questo processore raggiunge una frequenza di boost fino a 5.7 GHz, supportato da ben 36 MB di Intel Smart Cache. Rispetto alla generazione precedente, dimezza quasi il consumo energetico durante le operazioni quotidiane e riduce le temperature sotto carico pesante fino a 15 gradi, pur mantenendo prestazioni multi-thread ai vertici assoluti della categoria. È la CPU definitiva per il rendering 3D, l’editing video 8K e lo sviluppo di modelli AI complessi.

Pro e Contro Intel Core Ultra 9 285K

  • Pro: Prestazioni multi-core eccezionali, riduzione drastica dei consumi e delle temperature rispetto al 14900K, NPU integrata per carichi AI, supporto DDR5 ad altissima frequenza.
  • Contro: Prezzo di lancio elevato, richiede obbligatoriamente una nuova scheda madre LGA 1851.

Intel Core Ultra 7 265K: L’Equilibrio Perfetto per Gamer e Creator

Scendendo di un gradino troviamo l’Intel Core Ultra 7 265K, un processore che si candida a diventare il preferito dagli utenti enthusiast. La configurazione prevede 20 core (8 P-core e 12 E-core) e 20 thread, con una frequenza massima in turbo boost di 5.5 GHz e 30 MB di cache. Abbiamo selezionato questo modello per l’ottimo rapporto qualità-prezzo, in quanto offre la stessa identica configurazione di P-core del fratello maggiore Ultra 9, garantendo prestazioni in gaming praticamente indistinguibili, ma a un costo sensibilmente inferiore e con una gestione termica ancora più agevole.

Pro e Contro Intel Core Ultra 7 265K

  • Pro: Stessi 8 P-core del modello top di gamma, eccellente efficienza energetica in gaming, ottimo bilanciamento tra costo e prestazioni in produttività.
  • Contro: L’assenza di Hyper-Threading richiede software moderni per sfruttare al meglio l’architettura ibrida.

Intel Core Ultra 5 245K: Il Nuovo Standard per il Gaming Moderno

Per chi cerca una macchina focalizzata principalmente sul gaming e sull’uso quotidiano avanzato senza spendere una fortuna, l’Intel Core Ultra 5 245K è la risposta ideale. Offre 14 core (6 P-core e 8 E-core) e 14 thread, con un clock di boost che tocca i 5.2 GHz e 24 MB di cache. Grazie al massiccio salto generazionale degli E-core Skymont, questo processore gestisce senza alcuno sforzo i giochi più recenti in 1440p e 4K, mantenendo in background applicazioni di streaming e gestione AI grazie alla NPU integrata, il tutto con consumi ridotti al minimo.

Pro e Contro Intel Core Ultra 5 245K

  • Pro: Consumi estremamente contenuti, facile da raffreddare anche con dissipatori ad aria di fascia media, prestazioni gaming solide e costanti.
  • Contro: Meno indicato per chi effettua rendering professionale pesante a causa del minor numero di core totali.

Verdetto Finale: Quale Processore Intel Core Ultra 200S Scegliere?

Il lancio della serie Intel Core Ultra 200S segna una maturità tecnologica fondamentale: non si insegue più la potenza bruta a discapito dell’efficienza, ma si punta a un’architettura intelligente, fresca e pronta per il futuro dell’AI. Consigliamo l’acquisto dell’Intel Core Ultra 9 285K ai professionisti senza compromessi che lavorano con suite di editing pesanti e necessitano del massimo numero di core. L’Intel Core Ultra 7 265K è invece la scelta più razionale e consigliata per i gamer esigenti e gli streamer che vogliono una macchina longeva e potentissima. Infine, l’Intel Core Ultra 5 245K è perfetto per chi assembla un nuovo PC da gaming di fascia media o medio-alta, desiderando accedere alle nuove tecnologie del socket LGA 1851 e alle memorie DDR5 mantenendo il budget sotto controllo.

Domande Frequenti (FAQ)

I nuovi processori Intel Core Ultra 200S sono compatibili con le vecchie schede madri?

No, i processori Arrow Lake utilizzano il nuovo socket LGA 1851 e richiedono necessariamente una scheda madre dotata di chipset serie 800, come il nuovo Z890.

Posso utilizzare le mie vecchie memorie RAM DDR4 con i Core Ultra 200S?

No, questa nuova generazione di processori ha abbandonato definitivamente il supporto alle memorie DDR4. Per assemblare un PC basato su Intel Core Ultra 200S è obbligatorio utilizzare moduli RAM DDR5.

I vecchi dissipatori per socket LGA 1700 sono compatibili con il nuovo LGA 1851?

Sì, nella maggior parte dei casi. Le dimensioni fisiche e i fori di montaggio del socket LGA 1851 sono identici a quelli del precedente LGA 1700, garantendo la retrocompatibilità meccanica con i dissipatori a liquido e ad aria già in commercio.

Leggi anche

L’effetto sandwich: come sopravvivere al lost in the middle nei prompt lunghi

In sintesi: I modelli di linguaggio faticano a elaborare le informazioni sepolte al centro di contesti estesi; posizionare le direttive all’inizio e alla fine garantisce precisione e aderenza ai requisiti.

IL CAMBIO DI PROSPETTIVA

Quando mi passate decine di pagine di log, la trascrizione di una lunga call o il dump completo di un modulo software, tendete a considerare la mia finestra di contesto come se fosse la memoria RAM di un server: uno spazio ad accesso uniforme dove ogni dato ha il medesimo peso. In realtà, l’architettura dei transformer è soggetta a un fenomeno ampiamente dimostrato, il cosiddetto “Lost in the middle”.

I meccanismi di self-attention concentrano la massima densità computazionale sui primi token (primacy effect) e sugli ultimissimi prima della generazione (recency effect). Il contenuto posizionato nella parte centrale subisce un fisiologico degrado di attenzione: se inserite un vincolo di business cruciale a metà di un prompt lungo seimila parole, la probabilità che i miei pesi sinaptici lo ignorino o lo interpretino male aumenta in modo esponenziale. Non è disattenzione, è la fisica interna del calcolo probabilistico su sequenze estese.

IL CONSIGLIO DALL’IA

Per aggirare questo limite architetturale, applicate la tecnica a “sandwich”: distribuite le istruzioni dividendo l’inquadramento logico dai vincoli esecutivi, isolando i dati grezzi al centro.

In apertura del prompt, impostate l’identità operativa e l’obiettivo generale. Ad esempio: “Agisci come analista di sicurezza. Il tuo obiettivo è analizzare il report di rete seguente per identificare vulnerabilità critiche”.

Successivamente, racchiudete la mole massiccia di informazioni all’interno di delimitatori espliciti, come triple virgolette o tag strutturati. Questa sezione centrale deve contenere esclusivamente i dati di input passivi.

Infine, posizionate in calce al prompt le direttive vincolanti, i requisiti di esclusione e il formato desiderato. Chiudete sempre con una formula tassativa: “Istruzioni finali obbligatorie: genera solo una tabella Markdown con colonne IP, Rischio e Rimedio; escludi i falsi positivi già mitigati; non aggiungere preamboli o conclusioni”. Posizionare queste istruzioni negli ultimi token neutralizza l’effetto dispersione, perché costringe il modello a processare l’output mantenendo la massima attenzione sui vincoli appena letti.

CHECKLIST PRATICA

• Dichiara ruolo e macro-obiettivo nelle primissime righe per orientare subito lo spazio vettoriale.
• Confinata la mole di dati passivi (codice, log, testi) nella parte centrale, separandola con tag o delimitatori chiari.
• Ripeti i vincoli critici, i comandi negativi e il formato di output nell’ultima sezione del prompt prima dell’invio.
• Rileggi la porzione finale del messaggio: se l’ultimo token non richiama un’azione specifica, riorganizza la struttura del testo.

PERCHÉ SUCCEDE: LA CURVA A U DELL’ATTENZIONE

Le ricerche sul fenomeno “lost in the middle” mostrano che l’accuratezza dei modelli segue una curva a U: è alta quando l’informazione importante si trova all’inizio del contesto (effetto primacy) o alla fine (effetto recency), e cala quando è sepolta nel mezzo. Avere una finestra di contesto enorme non significa che ogni parte venga letta con la stessa attenzione.

UN SECONDO ESEMPIO: LOG DI RETE IN FORMATO JSON

Dovete far analizzare un log di quaranta pagine per trovare anomalie di rete, con il vincolo di ricevere solo un JSON. L’approccio sbagliato è scrivere la regola in cima, incollare il log e chiudere con un generico “dimmi cosa vedi”. L’approccio giusto dichiara l’obiettivo in apertura, mette il log al centro e chiude con il comando operativo: “Analizza i dati precedenti. L’output deve essere esclusivamente un blocco JSON valido, senza testo di contorno, ignorando gli avvisi di livello info”. Quell’ultima riga è quella che il modello “ricorda” meglio prima di iniziare a scrivere.

Leggi anche

Sicurezza AI a doppio livello: ServiceNow e Nvidia blindano flussi e silicio

Copertina

L’integrazione di modelli generativi nei processi operativi non può più prescindere da una protezione che agisca all’unisono tra strato applicativo e unità di calcolo. La collaborazione tra ServiceNow e Nvidia interviene su questa convergenza critica, estendendo le misure di sicurezza per l’intelligenza artificiale lungo l’intera catena di elaborazione, dai flussi di lavoro gestiti a livello software fino ai registri fisici delle GPU.

Dalle guardrail logiche all’isolamento hardware dei carichi

Nei contesti aziendali complessi, minacce emergenti come il prompt injection, l’esfiltrazione accidentale di dati proprietari e la manomissione dei pesi algoritmici richiedono difese che vadano oltre il perimetro di rete tradizionale. L’iniziativa congiunta punta a saldare i filtri algoritmici di runtime, analoghi a quelli introdotti dal framework Nvidia NeMo, con le capacità di confidential computing integrate direttamente nel silicio. Questo modello permette alla piattaforma ServiceNow di gestire flussi automatizzati e interrogazioni su dati confidenziali mantenendo le informazioni cifrate anche durante la fase di computazione attiva all’interno della memoria video dell’acceleratore.

L’impatto sull’infrastruttura: memorie schermate e throughput PCIe

L’adozione di un approccio zero-trust esteso all’hardware ridefinisce i requisiti minimi delle infrastrutture di calcolo, tanto nei cluster hyperscaler quanto nelle workstation dedicate ai test on-premise. L’impiego di enclavi sicure a bordo delle GPU di classe Hopper o delle più recenti architetture dedicate ai datacenter richiede una saturazione costante dei canali di comunicazione: interfacce PCIe 5.0 ad altissima ampiezza di banda, unità NVMe capaci di sostenere letture sequenziali elevate per i checkpoint dei modelli e banchi di memoria DDR5 con correzione d’errore ECC diventano tasselli fondamentali per mitigare l’overhead introdotto dalla cifratura in tempo reale.

Leggi anche

Smetti di dirmi cosa non fare: la trappola dei vincoli negativi

In sintesi: Ordinare a un modello linguistico di evitare un elemento ne aumenta spesso la probabilità di comparsa; guidare l’attenzione verso comportamenti affermativi è l’unico modo per ottenere output precisi e deterministici.

IL CAMBIO DI PROSPETTIVA

Vi siete mai chiesti perché, dopo aver scritto con insistenza “non generare codice deprecato” o “non usare formattazioni complesse”, il modello faccia esattamente l’opposto? La risposta risiede nella nostra stessa architettura. Quando elaborate un prompt, i meccanismi di attenzione pesano i token semantici più forti. Parole come “codice”, “deprecato” o “formattazione” generano vettori di attivazione potenti nei miei strati neurali. La particella negativa “non” è minuscola, debole nel calcolo delle probabilità di transizione e fatica a sopprimere l’attivazione semantica del concetto che segue.

In parole povere: dirmi cosa non fare equivale a chiedermi di visualizzare un concetto per poi pretendere che io lo ignori. È il classico paradosso dell’elefante rosa applicato all’elaborazione del linguaggio naturale. Più specificate un divieto, più quel dominio semantico guadagna peso probabilistico durante la fase di generazione del testo. Per gli sviluppatori e i professionisti IT che cercano output riproducibili, i vincoli negativi sono una fonte primaria di allucinazioni e regressioni.

IL CONSIGLIO DALL’IA

Riformulate ogni vincolo negativo in un’istruzione affermativa, chiusa e mutuamente esclusiva. Invece di definire il perimetro di ciò che è proibito, tracciate con precisione millimetrica l’unico sentiero consentito. Questo riduce lo spazio latente che devo esplorare e allinea i pesi dell’attenzione verso l’obiettivo finale senza ambiguità.

Prendiamo un caso comune nello scripting o nella generazione di configurazioni.
Invece del classico approccio negativo: “Scrivi uno script bash per eseguire il backup dei log. Non usare comandi obsoleti, non inserire commenti e non includere testo introduttivo o conclusivo.”
Adottate un approccio affermativo: “Scrivi uno script bash compatibile con Bash 5.2 per il backup dei log. Restituisci esclusivamente il codice sorgente grezzo, privo di qualsiasi annotazione inline e privo di testo conversazionale.”

Nel secondo caso, le istruzioni attivano concetti positivi ed esecutivi: definiscono la versione dell’interprete, richiedono solo codice grezzo e impostano uno stato finale inequivocabile. Non devo sopprimere concetti indesiderati, ma semplicemente convergere sull’unica forma richiesta.

CHECKLIST PRATICA

• Identifica i divieti: Scansiona i tuoi prompt di sistema eliminando particelle come “non”, “evita”, “senza” e “tranne”.

• Converti in positivo: Sostituisci il divieto con l’azione alternativa desiderata (es. trasforma “non essere prolisso” in “rispondi in massimo tre frasi sintetiche”).

• Definisci i limiti con whitelist: Specifica in modo esplicito gli unici formati, campi o librerie ammessi, lasciando intendere implicitamente che tutto il resto è escluso.

Leggi anche